본 포스팅은 Tenorshare로부터 소프트웨어 제품 라이선스와 원고료를 제공받았습니다.
홈페이지와 블로그 업무를 하다 보면 PDF에서 필요한 문장만 가져오거나 날짜를 바꿔야 할 때가 있습니다. 그런데 문서를 열었을 때 글자가 보인다고 모두 복사할 수 있는 것은 아닙니다. 페이지가 이미지로 들어간 PDF는 드래그해도 문장이 선택되지 않아 다시 입력하는 일이 생깁니다.
이번에는 홈페이지 화면과 한국어 설명, 일정과 금액 표가 들어 있는 5페이지 문서를 Tenorshare PDNob으로 열어봤습니다. 글자를 읽어내는 OCR부터 날짜 수정과 Word 변환까지 이어가니, PDF를 읽는 일과 내용을 다시 쓰는 일이 어떻게 다른지 알 수 있었습니다.
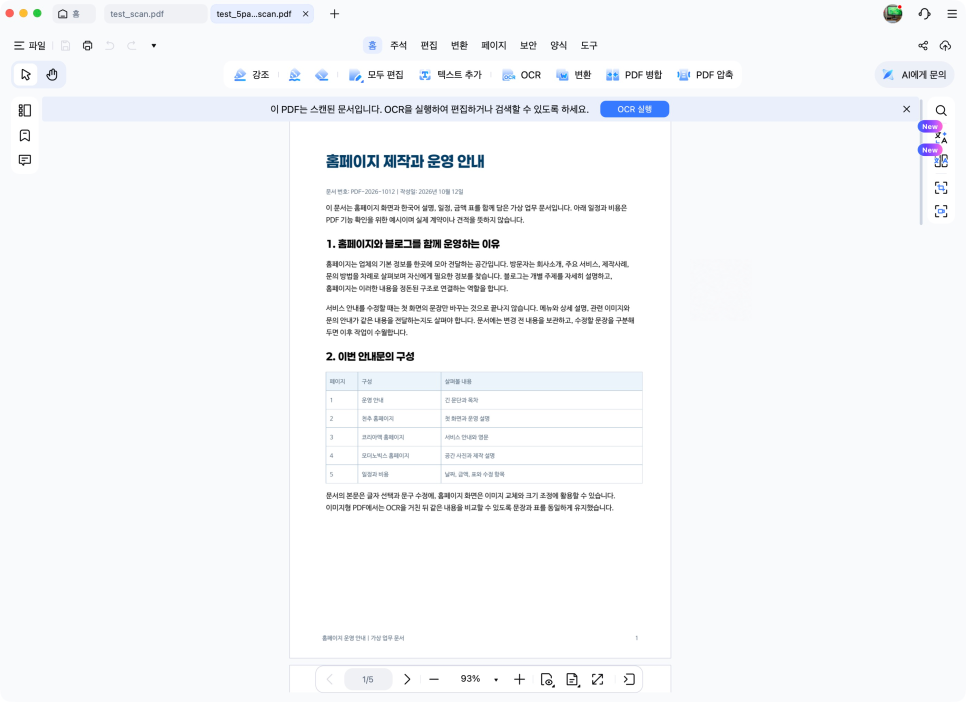
제가 사용한 Mac용 버전은 2.1.5입니다. 프로그램은 Tenorshare PDNob 다운로드에서 받을 수 있습니다. 저는 제공받은 라이선스로 사용했으므로, 아래 경험을 체험판에서 모든 기능을 제한 없이 쓴 결과로 받아들이지는 않으셨으면 합니다.
글자가 선택되지 않는 PDF에서 시작
이미지형 PDF는 화면을 확대하면 글씨가 또렷해도 안에는 글자 정보가 없을 수 있습니다. 제가 연 문서도 OCR 전에는 페이지 안의 문장을 일반 텍스트처럼 가져올 수 없었습니다. 이런 자료에서 필요한 내용을 꺼내는 첫 단계가 PDF 텍스트 추출입니다.
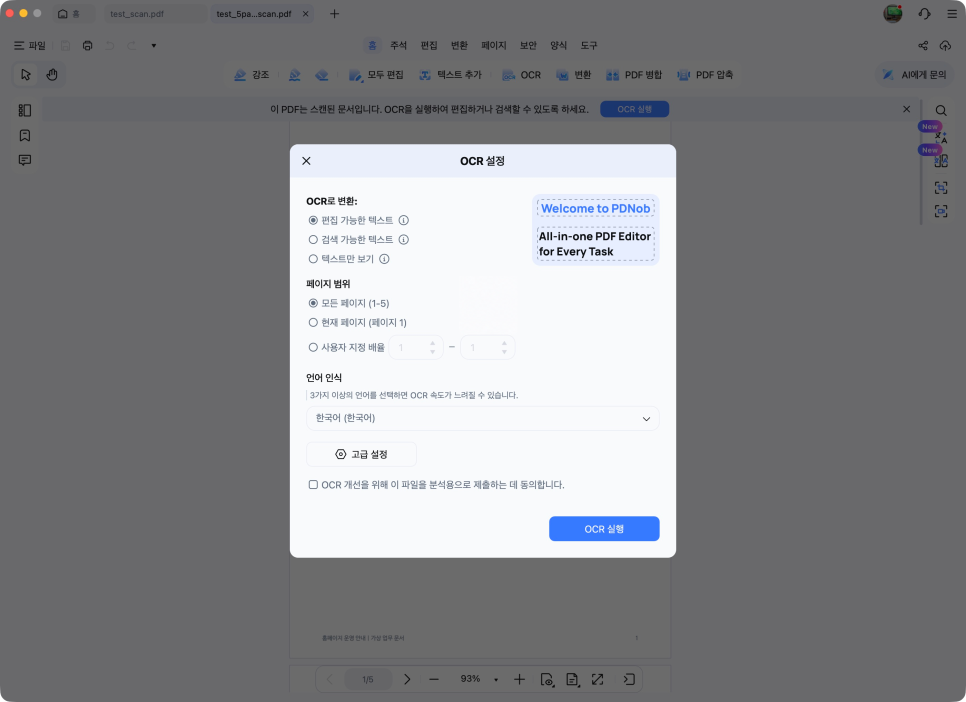
OCR 설정에서는 편집 가능한 텍스트, 검색 가능한 텍스트, 텍스트만 보기 중 목적에 맞게 고를 수 있었습니다. 이번에는 날짜를 직접 고칠 생각이라 편집 가능한 텍스트를 선택하고, 범위는 전체 5페이지로 정했습니다. 읽기와 검색만 필요한 문서라면 작업 목적이 달라지는 것이지요.
인식 언어는 우선 한국어를 선택했습니다. 한글 설명이 중심이어도 영문 서비스명이나 파일 형식이 섞여 있다면 해당 언어까지 함께 살펴야 합니다.
한국어 본문과 금액은 어떻게 읽혔을까
OCR을 마치니 문장과 표 안의 글자가 편집 대상으로 나뉘었습니다. 길게 이어진 한국어 설명을 다시 타이핑하는 대신, 읽어낸 내용을 바탕으로 손볼 수 있다는 점이 편했습니다.
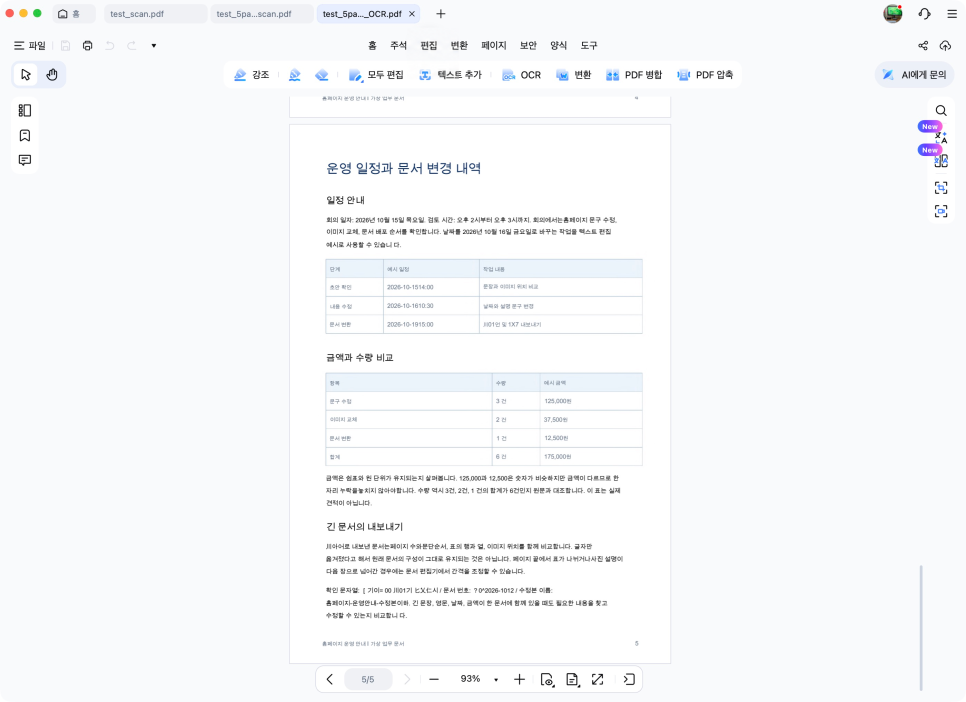
표에 넣은 125,000원, 37,500원, 12,500원과 합계 175,000원은 숫자와 쉼표를 읽어냈습니다. 다만 문장 사이의 띄어쓰기와 줄바꿈에는 차이가 있었습니다. 숫자가 맞았다고 문서 전체가 원문과 같아지는 것은 아니어서, 가져온 문장을 그대로 배포하기 전에 한 번 읽어봐야 했습니다.
한국어만 선택한 이번 결과에서는 Word 같은 영문과 문서 번호의 일부가 다른 문자로 읽혔습니다. 작은 글자가 많이 들어간 홈페이지 화면에서도 오류가 생겼습니다. PDF OCR 변환은 내용을 다시 활용할 출발점으로 쓰되, 영문·날짜·금액처럼 의미가 달라지기 쉬운 부분은 원문과 비교하는 편이 좋겠습니다.
고급 설정과 이미지가 섞인 페이지
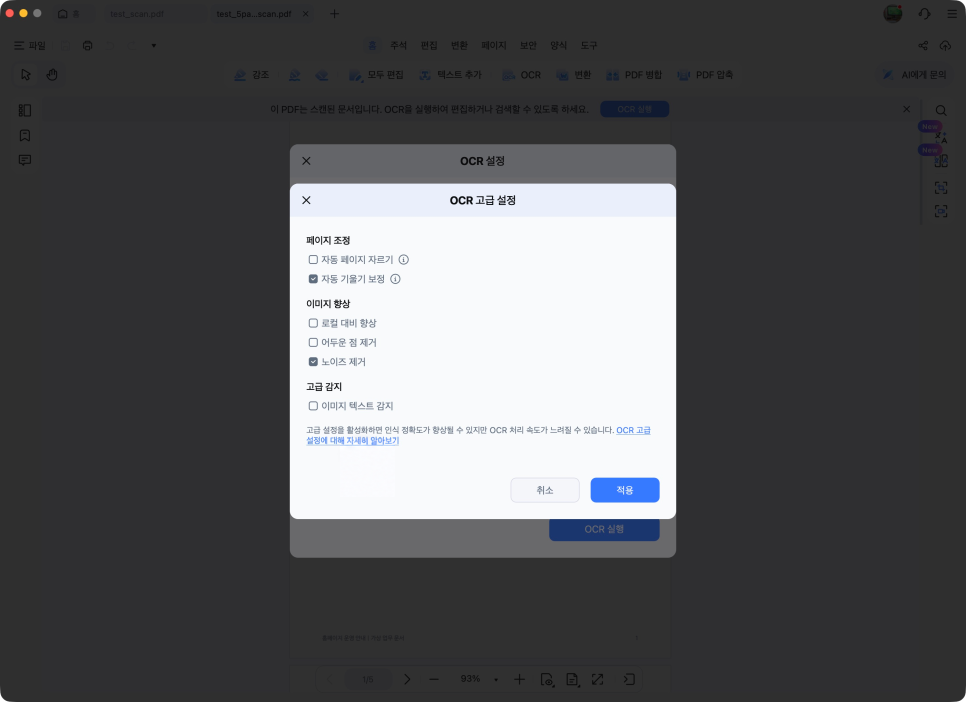
OCR 고급 설정에는 자동 기울기 보정, 노이즈 제거, 이미지 텍스트 감지 등의 항목이 있었습니다. 이번 문서는 반듯한 페이지였으므로, 기울어진 종이나 흐린 사진에서도 같은 결과가 나온다고 말하기는 어렵습니다. 원본 상태에 따라 필요한 옵션을 골라야 할 부분입니다.
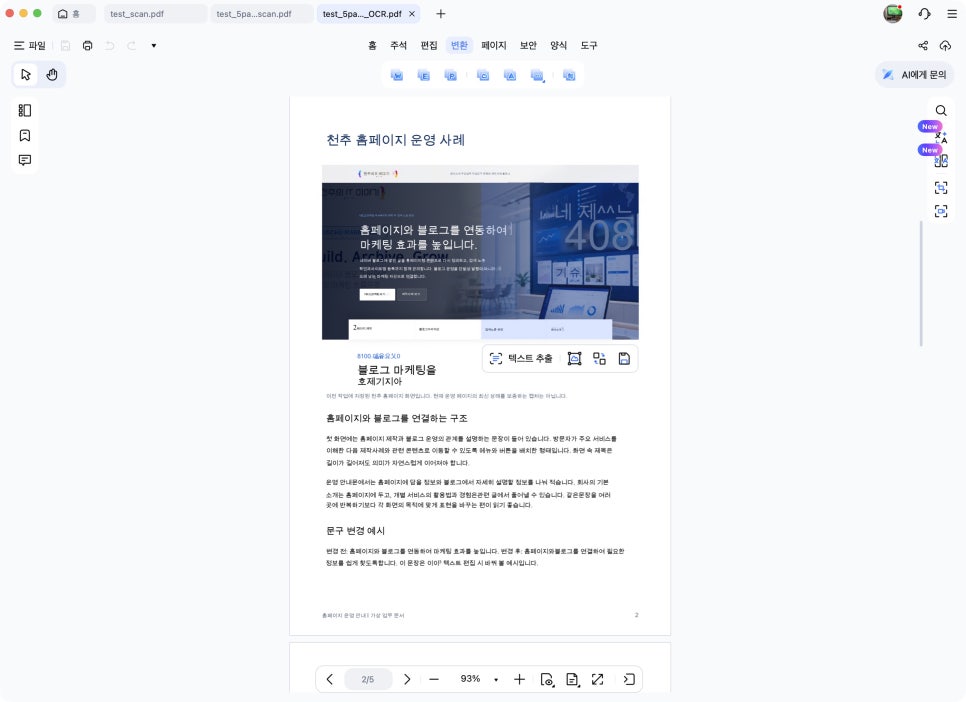
홈페이지 화면처럼 사진과 제목, 작은 메뉴 글자가 한 장에 섞여 있으면 단순한 본문보다 까다로웠습니다. 화면 안의 문구까지 텍스트로 나뉘면서 일부 글자 모양과 배치가 달라졌습니다. 문서 설명은 가져오고 싶어도 화면 이미지는 원래 모습을 유지하고 싶은 경우가 있으니, 변환 후 사진 부분도 함께 봐야 합니다.
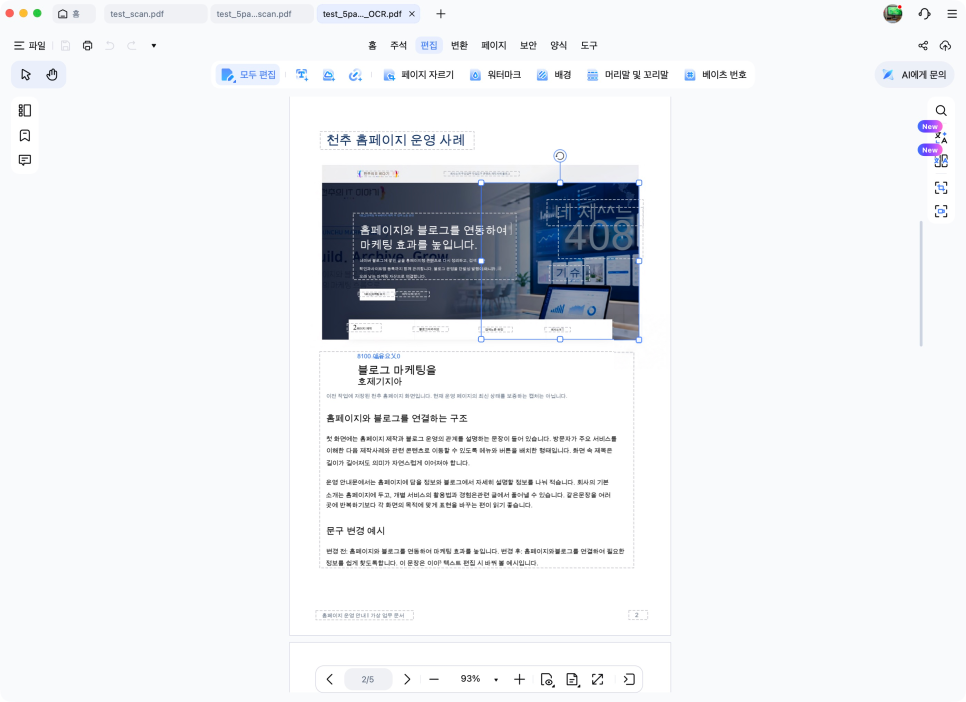
편집 모드에서 이미지 영역을 선택하면 크기 조절점이 나타났습니다. 다만 OCR을 거친 화면 이미지는 사진 한 장처럼 단순하게 다뤄지지 않는 경우가 있었습니다. 이미지가 중심인 안내물이라면 문구 추출과 사진 배치 유지를 나눠 생각하는 편이 좋겠습니다.
PDF 안에서 날짜만 바꿔보기
수정할 내용이 몇 글자라면 Word로 옮기기 전에 PDF 안에서 바로 손볼 수 있습니다. 저는 일정 안내에 있던 ‘15일 목요일’을 선택해 ‘16일 금요일’로 바꿨습니다. 필요한 부분만 선택해 입력하니 주변 설명을 다시 만들지 않고 날짜를 수정할 수 있었습니다.
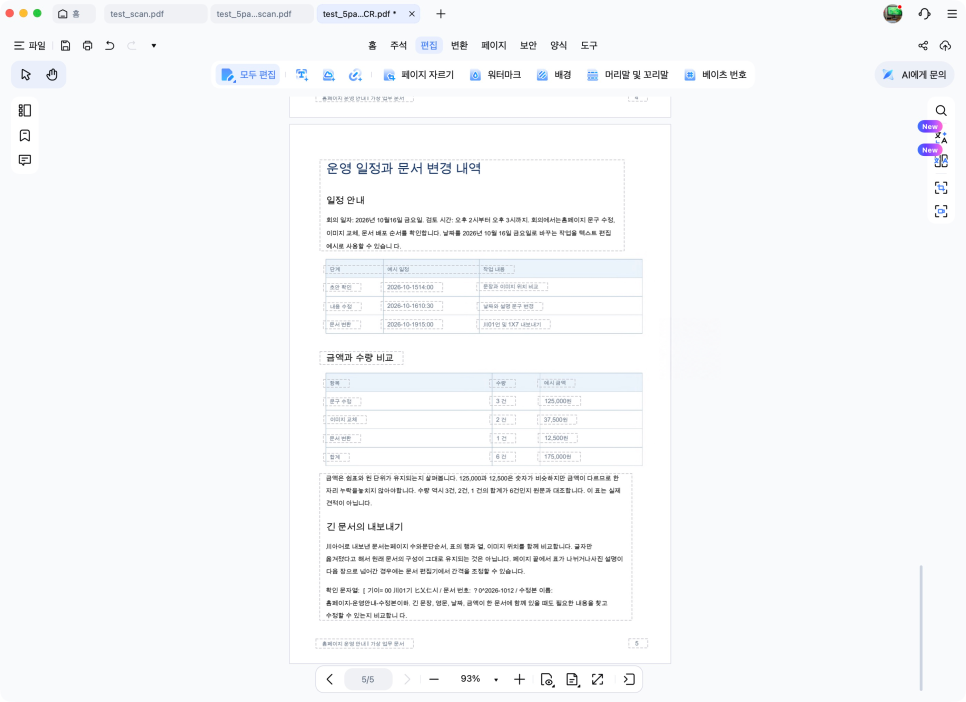
여기서는 선택하는 범위가 중요했습니다. 제목과 본문이 한 편집 영역에 함께 잡히기도 해서, 전체를 한꺼번에 바꾸면 글자 크기나 줄 수가 달라질 수 있었습니다. 짧은 날짜 수정은 해당 글자만 골라 바꾸는 편이 원래 배치를 유지하기 좋았습니다.
안내문의 시간을 바꾸거나 짧은 문구를 고칠 때는 이런 방식이 유용합니다. 문단을 길게 추가하거나 순서를 크게 바꾸려면 문서 편집기로 이어가는 쪽이 수월합니다.
Word로 옮겨 다음 작업 이어가기
변환 메뉴에서 Word를 선택하고 전체 5페이지를 내보냈습니다. 파일 형식과 저장 위치를 같은 창에서 정할 수 있었고, 작업이 끝난 뒤 DOCX 파일이 생겼습니다. OCR과 편집을 한 프로그램에서 마친 다음 다른 문서 형식으로 이어갈 수 있는 흐름입니다.
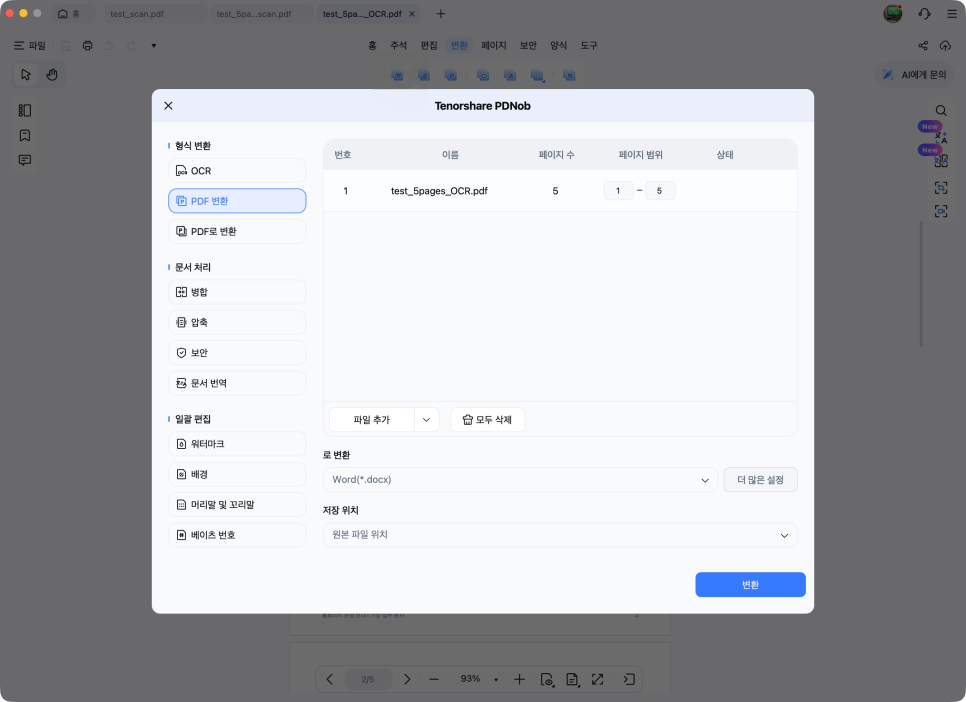
변환된 파일 안에도 한국어 문장과 표의 내용, 이미지가 들어 있었습니다. 앞에서 바꾼 ‘16일 금요일’도 Word 파일의 텍스트에 반영됐습니다. 다만 영문 인식 오류까지 자동으로 고쳐지는 것은 아니며, 글꼴과 표 배치는 여는 프로그램에서 다시 살펴야 합니다.
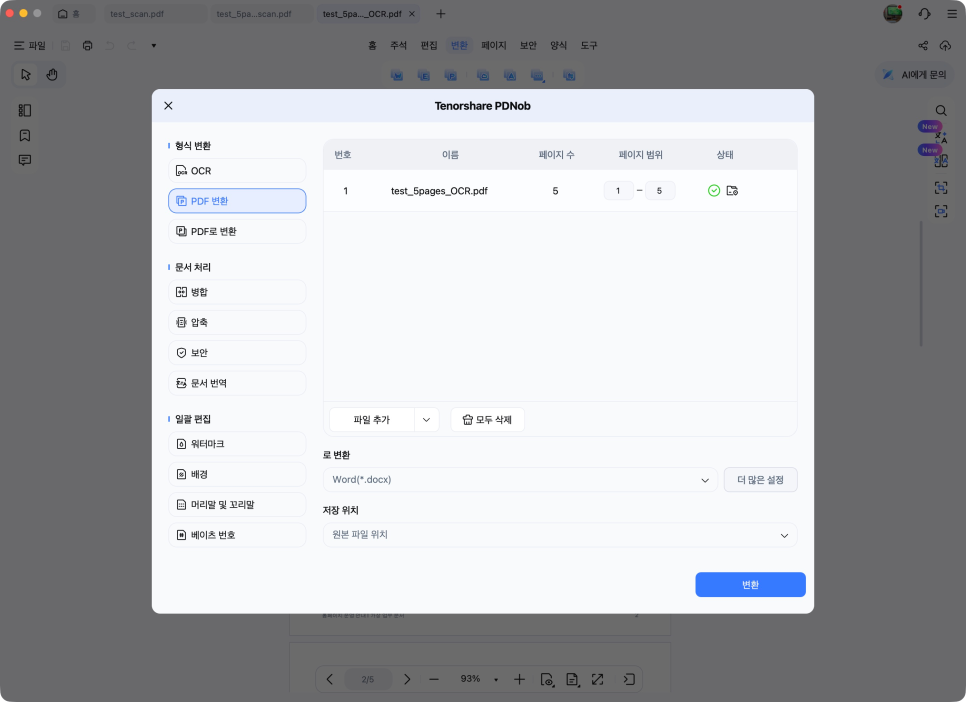
PDF 텍스트 추출만 할 때와 문서 모양까지 살려 이어 쓸 때는 기대하는 결과가 다릅니다. 문장을 꺼내고 날짜를 고치는 작업은 편했지만, 사진과 작은 글씨가 많은 페이지는 추가 손질을 염두에 두는 편이 좋겠습니다.
PDF 텍스트 추출 결론
무료 PDF 편집기를 찾을 때는 무료 다운로드·체험과 실제 이용할 기능의 범위를 나눠 봐야 합니다. 저는 라이선스가 적용된 환경에서 OCR과 편집, Word 변환을 진행했습니다. 같은 작업을 하려는 분은 체험판에서 가능한 저장과 변환 조건부터 살펴보시면 좋겠습니다.
PDNob은 이미지형 PDF의 내용을 꺼내 수정하고 Word 작업으로 이어가려는 경우에 살펴볼 만했습니다. 한국어 본문에서는 재입력하는 수고를 줄였고, 영문이나 작은 글씨는 결과를 대조해야 했습니다. 평소 다루는 PDF로 먼저 써보시면 활용할 부분이 더 잘 보일 것입니다.